Transformaciones de Puntajes: Mejorando la Interpretación de Datos.
Las transformaciones de puntajes son técnicas utilizadas para modificar la escala o la distribución de los valores en un conjunto de datos. Estas técnicas se aplican con el propósito de hacer que...
¿Cómo y cuándo hacer una prueba Kruskal-Wallis para muestras independientes? – Ejemplo en JASP
En la investigación a menudo encontramos varias formas de abordar un problema o tratamiento. En estos casos, es necesario incluir múltiples condiciones para comparar cuál de ellas es más eficaz o...
Red nomológica: El constructo detrás de un instrumento
.
Por: Luciana Salome Chumpitaz Polanco
En el ámbito de la psicología, suele trabajarse con fenómenos que no son directamente observables, pero que sí pueden estudiarse a...
El Rigor en la Investigación Cualitativa
Si desea que nadie dude de que su investigación cualitativa es válida y confiable, es fundamental implementar el rigor científico a la hora de realizarla, ya que este brinda un robustecimiento a...
Estrategias de muestreo cualitativo
¿Llegó el momento de elegir la muestra para su investigación cualitativa y no sabe cómo proceder? Este texto le podría servir de guía, ya que aborda los tipos de muestras y sus respectivas...
Identificación de sesgos en los ítems: una guía práctica
En la construcción de instrumentos es importante garantizar que los ítems sean interpretados de la misma manera por todos los participantes, sin embargo, algunas veces algunos ítems pueden...
Codificación cualitativa: el puente entre los datos y la interpretación
.
Por: Laura Violetha Mora Estrella
La codificación puede entenderse como catalogar una biblioteca antigua. No se trata solo de hacer una lista de los títulos (los datos),...
Codificación focalizada
Si usted se encuentra realizando un análisis cualitativo, en primera instancia debió llevar a cabo una primera codificación, es decir, organizar los datos a partir de etiquetas que reflejen los...
Teoría Clásica de los Test
Desde tiempos muy antiguos, las personas han buscado medir distintos elementos del entorno con la intención de comprenderlos mejor. En contextos educativos y de evaluación psicológica esta...
Mapas semánticos
Los mapas semánticos son herramientas visuales utilizadas en lingüística y psicología para representar las relaciones entre significados o conceptos. Estos mapas permiten organizar información...
Una breve historia sobre el autismo
Una creencia que se ha esparcido, especialmente durante las últimas décadas, es que antes no había tantos casos de autismo llegando incluso a propiciar movimientos no sólo equivocados sino...
La bitácora analítica: la voz transparente del investigador
Es común observar a un músico, un escritor o a un artista llevando un pequeño cuaderno, un grupo de hojas o una grabadora de voz en su vida diaria, realmente nunca se sabe cuándo puede llegar la...
Las transformaciones de puntajes son técnicas utilizadas para modificar la escala o la distribución de los valores en un conjunto de datos. Estas técnicas se aplican con el propósito de hacer que los datos sean más interpretables, adecuados para ciertos análisis estadísticos o para cumplir con ciertos supuestos de los métodos estadísticos.
Existen varias razones por las cuales las transformaciones de puntajes son útiles en el análisis de datos:
Cumplimiento de Supuestos Estadísticos: Algunos análisis y modelos estadísticos tienen supuestos específicos sobre la distribución de los datos. Entre los supuestos más comunes se encuentran la normalidad de los residuos, la homocedasticidad (igualdad de varianzas entre grupos) y la independencia de las observaciones. Las transformaciones pueden hacer que los datos se ajusten mejor a estos supuestos, mejorando la validez de los resultados. Por ejemplo, si los datos de una variable presentan asimetría positiva, una transformación logarítmica puede aproximarlos a una distribución normal, permitiendo el uso válido de pruebas paramétricas como la prueba t o el análisis de varianza.
Normalización de Datos: En ocasiones, los datos pueden no tener una distribución normal, así las transformaciones pueden ayudar a aproximarse a esta distribución, lo que facilita la aplicación de pruebas estadísticas y modelos que asumen este supuesto.
Reducción de Sesgo: Los datos pueden tener sesgos, lo que significa que se distribuyen hacia un extremo de la escala. Las transformaciones pueden reducir o eliminar este sesgo, lo que puede mejorar la precisión de los análisis y las interpretaciones.
Homogeneización de Varianzas: Algunos métodos estadísticos requieren que las varianzas sean homogéneas entre grupos o variables. Las transformaciones pueden ayudar a igualar las varianzas y permitir un análisis más preciso. Por ejemplo, en psicología educativa, cuando se comparan los puntajes de ansiedad de grupos de estudiantes de diferentes instituciones, las varianzas suelen ser distintas. Aplicar una transformación logarítmica puede homogeneizar esas varianzas y hacer válido el uso de una prueba como el ANOVA.
Mejora de Interpretación: Algunas escalas de medición pueden ser difíciles de interpretar directamente. Las transformaciones pueden hacer que los valores sean más comprensibles y significativos en el contexto del problema. Por ejemplo, una escala de actitudes hacia la lectura que va de -50 a +50 puede transformarse a una escala de 0 a 100, lo cual resulta más intuitivo para los participantes y facilita la comunicación de los resultados. Del mismo modo, cuando los valores originales oscilan entre 10.000 y 100.000, convertirlos a una escala de 0 a 100 mejora notablemente su interpretación.
Comparación de Diferentes Escalas: las transformaciones permiten poner en una misma escala los puntajes y así hacerlos comparables.
Reducción de valores atípicos: En ocasiones, los valores atípicos pueden distorsionar los análisis. Las transformaciones pueden mitigar el impacto de estos valores extremos. Por ejemplo, en un estudio sobre tiempos de reacción en una tarea cognitiva, algunos participantes pueden presentar latencias muy elevadas (superiores a 3000 ms) que inflan la media del grupo. Aplicar una transformación de raíz cuadrada o logarítmica reduce la influencia desproporcionada de esos valores sin necesidad de eliminarlos del conjunto de datos.
Al elegir y aplicar las transformaciones adecuadas, los investigadores pueden obtener una comprensión más profunda y significativa de los datos y sus patrones subyacentes. En este sentido, existen diferentes escenarios en los que se requiere hacer esta transformación a fin de entender o interpretar la información recolectada. Adicional a las razones ya mencionadas, cuando se tiene alguna de las siguientes situaciones se puede requerir realizar la transformación de las puntuaciones:
Variables con Relaciones No Lineales: Si se detecta que la relación entre dos variables sigue un patrón curvilíneo, las transformaciones permiten convertirla en una relación lineal que los modelos estadísticos clásicos pueden analizar correctamente. Por ejemplo, en psicología del desarrollo, la relación entre la edad y ciertos desempeños cognitivos suele ser curvilínea: el rendimiento aumenta en la niñez, se estabiliza en la adultez y declina en la vejez. Transformar la variable de edad mediante una función cuadrática o logarítmica puede linealizar esa relación y posibilitar el uso de regresión lineal.
Datos Monetarios o Proporcionales: En casos en que los datos son valores monetarios o proporcionales, las transformaciones pueden ayudar a reducir la asimetría y lograr una distribución más adecuada para el análisis.
Modelos de Regresión: En análisis de regresión, las transformaciones pueden mejorar la linealidad entre variables y cumplir con los supuestos de los modelos.
Análisis de Supervivencia: En análisis de supervivencia o datos de tiempo hasta un evento, las transformaciones pueden mejorar la distribución del tiempo hasta el evento y permitir un análisis más preciso.
Comparación de Grupos con Diferentes Tamaños: Al comparar grupos con diferentes tamaños, las transformaciones pueden ayudar a igualar la influencia de los diferentes tamaños de muestra en el análisis.
Si bien existen diferentes tipos de transformación de datos, tales como logarítmica, por rangos, raíz cuadrada, Box-Cox, Logit y Probit, entre otras, en esta guía se van a presentar dos transformaciones utilizadas con frecuencia en el análisis cuantitativo variables propias de la psicología: puntaje z y puntaje T.
Antes de realizar cualquier transformación, es importante entender los datos originales y seleccionar el tipo de transformación adecuado:
Entender los Datos Originales es el primer paso crítico antes de aplicar transformaciones. Esto permitirá tomar decisiones informadas y garantizar que las transformaciones sean apropiadas y efectivas en la mejora de la calidad de los datos y los resultados analíticos. Ignorar esta fase podría llevar a errores y resultados incorrectos en el análisis. Tener la comprensión de los datos originales permite:
Realizar Transformaciones Inapropiadas: Aplicar transformaciones sin entender los datos originales puede resultar en interpretaciones erróneas o en la eliminación de información relevante. Por ejemplo, aplicar una transformación logarítmica a datos que ya están normalmente distribuidos puede distorsionar la interpretación.
Tomar decisiones informadas: es esencial comprender cómo se distribuyen los datos y qué patrones subyacentes existen, lo cual permite identificar el tipo de transformación es adecuado para los datos y los objetivos analíticos.
Seleccionarla Transformación Adecuada: Al analizar los datos originales se identifican problemas como la asimetría, la falta de normalidad o la presencia de valores atípicos, lo cual ayuda a elegir la transformación más efectiva para abordar los problemas específicos.
Realizar Transformaciones Inapropiadas: Aplicar transformaciones sin entender los datos originales puede resultar en interpretaciones erróneas o en la eliminación de información relevante. Por ejemplo, aplicar una transformación logarítmica a datos que ya están normalmente distribuidos puede distorsionar la interpretación.
Seleccionar el Tipo de Transformación Adecuado Después de analizar los datos originales y comprender sus patrones de distribución, sesgo y valores atípicos, el proceso para elegir la transformación adecuada es:
Identificar el Problema: reconocer los problemas específicos que se presentan en los datos, tales como asimetría en la distribución, valores atípicos influyentes, falta de normalidad, entre otros.
Elegir la Transformación:
Transformación Logarítmica: Consiste en aplicar la función logarítmica a cada valor del conjunto de datos. Esta transformación es útil cuando los datos presentan sesgo positivo o valores atípicos elevados, ya que comprime los valores grandes y amplía los pequeños, acercando la distribución a la normalidad. Es especialmente adecuada cuando los datos son positivos y presentan varianzas que aumentan con la media.
Transformación Z-Score: Estandariza los datos alrededor de la media y es útil para normalizar datos y compararlos directamente.
Transformación de Raíz Cuadrada: Consiste en calcular la raíz cuadrada de cada valor del conjunto de datos. Al igual que la transformación logarítmica, reduce el sesgo positivo y estabiliza las varianzas, aunque con un efecto menos pronunciado. Es apropiada cuando los datos son positivos y presentan asimetría moderada. Por ejemplo, en estudios sobre frecuencia de conductas (número de errores, número de intentos), esta transformación es muy común. Nota: no puede aplicarse directamente a valores negativos; en ese caso, se suma una constante antes de aplicar la raíz.
Transformación de Box-Cox: Es una familia de transformaciones paramétricas que generaliza tanto la logarítmica como la de raíz cuadrada. Mediante un parámetro λ (lambda), se ajusta automáticamente la transformación más adecuada para normalizar los datos. Cuando λ = 0, equivale a la transformación logarítmica; cuando λ = 0.5, equivale a la raíz cuadrada. Requiere que todos los valores sean positivos y es especialmente útil cuando no se sabe de antemano qué transformación aplicar, ya que el valor óptimo de λ se estima estadísticamente a partir de los datos.
Transformación de Rango: Consiste en reemplazar cada valor por su rango o posición ordinal dentro del conjunto de datos. De esta forma, todos los valores se convierten en una escala uniforme que va de 1 a n (donde n es el número de observaciones). Esta transformación es robusta frente a valores atípicos y no asume ninguna distribución específica, lo que la hace adecuada para pruebas estadísticas no paramétricas. Es especialmente útil cuando la forma de la distribución no es un factor crítico para el análisis.
Calcular la Transformación: Una vez se ha elegido la transformación, se aplica la fórmula correspondiente a cada valor en el conjunto de datos.
Algunos ejemplos de selección, atendiendo a la problemática, pueden ser los siguientes:
Comparación de Diferentes Escalas: Supongamos que se requiere comparar el rendimiento de un paciente en dos pruebas psicométricas distintas: un test de Memoria de Trabajo (cuya puntuación directa máxima es de 45 puntos) y un test de Atención Sostenida (cuya puntuación directa máxima es de 120 puntos). Al medirse en escalas y unidades totalmente diferentes, las puntuaciones directas no se pueden comparar de forma directa. Para resolver esto, resulta indispensable aplicar la transformación de puntuaciones z (z-score) a ambos conjuntos de datos. Esto permite estandarizar los resultados en una escala común (con media 0 y desviación estándar 1), facilitando la comparación directa de las aptitudes del sujeto y la creación de un perfil neuropsicológico claro.
Asimetría en Datos Financieros: Supongamos que se está trabajando con una prueba de neuropsicología que mide el tiempo de reacción de los sujetos ante un estímulo visual, o bien, una escala que mide niveles de ansiedad clínica en la población general. Al analizar los datos, se encuentra que la distribución está fuertemente sesgada hacia la derecha (asimetría positiva), ya que la mayoría de las personas responden rápido o presentan niveles bajos de ansiedad, mientras que solo unos pocos puntúan extremadamente alto. En este caso, se aplica una transformación logarítmica para contraer la cola derecha de la distribución, reducir el sesgo y acercar los datos a una distribución normal, cumpliendo así con los supuestos de las pruebas estadísticas paramétricas.
Datos con Valores Atípicos: Si se está trabajando con un registro observacional del número de conductas disruptivas de un grupo de niños en el aula durante un mes, es muy probable que haya unos pocos niños (valores atípicos) con un conteo de conductas extremadamente alto que esté inflando artificialmente la media y la desviación estándar del grupo. Para mitigar esto, se opta por aplicar la transformación de raíz cuadrada (ideal para datos de conteo o frecuencias), lo que reduce la influencia de estos valores atípicos en el análisis global sin tener que eliminar a los sujetos de la muestra.
Realizar la Transformación:
Este es el paso final que conlleva a aplicar la fórmula respectiva. Para ejemplificar se presenta de forma detallada la transformación de un conjunto de datos a un puntaje Z (z-score).
Paso 1: Preparación
Tener los datos originales listos para trabajar.
Decidir que se va a aplicar la transformación de puntaje Z.
Paso 2: Calcular la Media y la Desviación Estándar
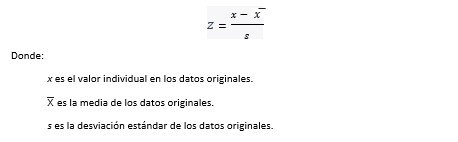
Calcular la media (μ) y la desviación estándar (σ) de los datos originales. Se puede hacer utilizando herramientas de análisis de datos como Excel, Python o R Studio.Paso 3: Calcular el Puntaje Z para Cada Valor.
Para cada valor en los datos originales, calcula el puntaje Z utilizando la siguiente fórmula:
Aplicar esta fórmula a cada valor en el conjunto de datos resultará en un conjunto de z-scores estandarizados.
Ejemplo:
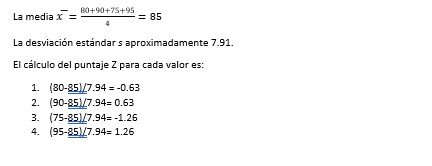
Supongamos que se tienen los siguientes datos originales de puntuaciones: [80, 90, 75, 95].
Paso 4: Interpretación de los Puntajes
En el puntaje z, se puede interpretar los valores de dos formas que, dependiendo de los intereses de la investigación, pueden dar información diferente, aunque complementaria.
¿Qué tan alejado está el dato de la media?
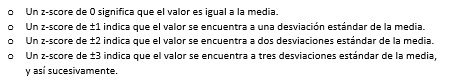
Un z-score positivo significa que el valor está por encima de la media.
Un z-score negativo significa que el valor está por debajo de la media.
Cuanto mayor sea el valor absoluto del z-score, más lejos está el valor de la media en términos de desviación estándar.
¿Cuál es la probabilidad asociada a dicho valor dentro de una distribución normal?
A menudo, se compara el z-score con una tabla de distribución normal estándar (también conocida como la tabla Z) para determinar la probabilidad asociada con ese z-score. Lo anterior ayudará a entender cuán inusual es el valor en comparación con la distribución normal estándar.
Ejemplo: Un puntaje Z de 1.26 significa que el valor original (95) está aproximadamente 1.26 desviaciones estándar por encima de la media (85). Así mismo, en términos de probabilidad, al consultar una tabla de distribución normal estándar para determinar cuántos porcentajes de datos están por debajo de este valor, una puntuación de 1.26 generalmente significa que el valor se encuentra por encima del 89% de los datos en la distribución (dependiendo de la precisión de la tabla de z-scores utilizada).
La transformación de puntaje Z es una forma de estandarizar los datos y compararlos en una misma escala. Esta transformación es útil cuando se desea entender cómo se comparan los valores individuales con respecto a la media y la dispersión de los datos originales. Sin embargo, la utilización o transformación de los datos originales siempre dependerá de los datos y el objetivo de la investigación.
Bibliografía.
Newbold P., Carlson W., & Thorne, B. (2013). Estadística para Administración y Economía. Madrid, España: Pearson Educación.
Rojo Blasco, J., & Sánchez Sánchez, J. M. (2011). Métodos estadísticos. Madrid, España: Paraninfo.
Saínz P.J. & Gallego D. (2010). Estadística Aplicada a las Ciencias Sociales. Madrid, España: Editorial Síntesis.





Add Comment