



Prueba de Friedman para muestras relacionadas
¿Cómo y cuándo hacer un test de Friedman para muestras relacionadas? – Ejemplo en JASP
.
Por: Aylen Zarhek Gutiérrez Nova
En la vida real, es frecuente observar cómo las personas reaccionan de manera distinta ante diversas situaciones, como cambios en su entorno, tratamientos médicos o estrategias educativas. Estas variaciones en las respuestas individuales son clave para entender el impacto de diferentes condiciones sobre un mismo grupo.
Analizar si existen diferencias significativas en cómo varían las respuestas entre condiciones es un fenómeno que se busca abordar de manera sistemática en la investigación. La prueba de hipótesis de Friedman es una herramienta estadística especialmente útil en estos contextos, ya que permite comparar tres o más mediciones relacionadas, incluso cuando los datos no cumplen con los supuestos de normalidad.
¿Qué es la prueba de Friedman?
La prueba de Friedman, también conocida como análisis de varianza en dos direcciones por rangos, es una prueba estadística no paramétrica que se utiliza para determinar si las distribuciones de tres o más medidas repetidas difieren entre sí. Se utiliza cuando la variable continua no cumple los supuestos necesarios para el ANOVA de medidas repetidas o cuando la variable de interés se mide en escala ordinal (Pérez-Tejada, 2008).
La prueba de Friedman es un diseño de bloques aleatorios en el que el número total de unidades experimentales, N, se organiza en n grupos homogéneos, llamados bloques. Cada bloque contiene k unidades experimentales, que corresponde al número de tratamientos, ya que cada tratamiento se aplica a una unidad dentro del bloque (Mendenhall, 2010; Pérez-Tejada, 2008; Siegel y Castellán, 1995). Dado que cada bloque contribuye con una unidad experimental por tratamiento, el tamaño de la muestra en cada condición es igual al número de bloques. Este diseño se basa en muestras igualadas, lo que significa que el mismo grupo de sujetos, o sujetos con características similares, se expone a todas las condiciones. Esto permite controlar la variabilidad entre individuos y aumentar la precisión de la prueba.
Pregunta de investigación e hipótesis.
En investigación, la prueba de Friedman se utiliza cuando se desea evaluar si los rangos centrales difieren entre condiciones relacionadas, en un diseño de medidas repetidas. Esto significa que las muestras son medidas repetidas en los mismos sujetos o unidades experimentales bajo diferentes condiciones o tratamientos.
De este modo, la hipótesis nula que se pone a prueba es que la variable de interés tiene la misma distribución en todas las muestras evaluadas, lo cual implica que las diferencias observadas entre las mediciones son simplemente el resultado del azar. Si la hipótesis nula es rechazada, significa que existen diferencias significativas entre al menos dos de las condiciones o tratamientos, sugiriendo que éstas sí tienen un efecto significativo sobre la variable dependiente (Mendenhall, 2010; Siegel y Castellán, 1995).
¿Cuándo hacer la prueba de Friedman?
La prueba de Friedman es adecuada para datos ordinales o continuos que no cumplen con los supuestos paramétricos (Siegel y Castellán, 1995). Asimismo, existen dos situaciones en las que se aplica esta prueba:
La primera, para una misma muestra, medida más de dos veces, es decir, cuando se mide a los mismos sujetos o unidades experimentales bajo más de dos condiciones o tratamientos diferentes. En este caso, cada sujeto sirve como su propio control, lo que aumenta la posibilidad de detectar diferencias significativas entre los tratamientos. Así, k representa el número de tratamientos o situaciones en las que se miden los sujetos.
En la segunda situación, la prueba se aplica cuando se tienen más de dos muestras que están correlacionadas o son dependientes entre sí. Aquí, k representa el número de muestras o grupos correlacionados que participan en el estudio.
Análisis Post Hoc
Obtener un valor significativo en la prueba de Friedman indica que al menos uno de los grupos es diferente de otro. No obstante, esto no nos dice qué grupos son diferentes entre sí, ni indica cuántos de los grupos son diferentes de cada uno.
Para determinar cuáles grupos son diferentes entre sí, debe utilizarse un método de comparaciones múltiples que permite determinar cuáles diferencias son significativas (Pereira et al., 2015; Siegel y Castellán, 1995).
La prueba de Nemenyi es una adaptación de la prueba de rango de Tukey que comprueba la diferencia entre las sumas ordenadas. Esta prueba se utiliza cuando se comparan todas las condiciones entre sí y controla la probabilidad de cometer error tipo I. Cuando se comparan todas las condiciones con un grupo control, se puede utilizar uno de los procedimientos generales para controlar la probabilidad de cometer error tipo I, como la corrección de Bonferroni o procedimientos similares (Demšar, 2006).
La prueba de Conover es otra prueba post hoc que se utiliza tras una prueba de Friedman significativa. Se trata de una prueba para comparaciones múltiples de sumas de rangos para un diseño de bloques incompletos equilibrados bidireccionales. Esta prueba no corrige la probabilidad de cometer error tipo I, por lo que es necesario utilizar algún tipo de factor de corrección de error, como Bonferroni (Pereira et al., 2015; Pohler, 2025).
Ejemplo. Una empresa de productos alimenticios busca optimizar el diseño de sus empaques para atraer consumidores. Así, realizan un estudio para determinar la preferencia de los consumidores por tres tipos de empaques: tradicional, ecológico y minimalista. Cada participante evalúa los tres empaques en términos de atractivo visual, utilizando una escala del 1 al 10, donde 1 es “nada atractivo” y 10 es “muy atractivo”. Los datos obtenidos se muestran a continuación.
- Para comenzar con el análisis, debemos abrir el archivo con nuestros datos, que previamente debió ser guardado en formato separado por comas (.csv). (Menú Principal. Abrir. Ordenador. Buscar. Nombre del archivo. Abrir).
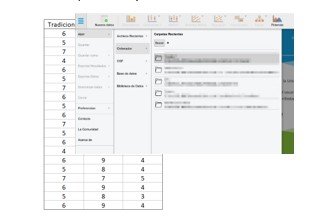
2. A continuación, verificamos que la escala de las variables se encuentre correctamente, y realizamos cambios de ser necesarios.
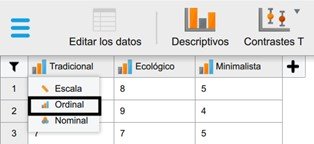
En nuestro caso, las tres variables se encuentran medidas en escala ordinal. Sin embargo, si estuviesen en escala de intervalo previo a realizar la prueba de Friedman, debe ser verificado que se incumple el supuesto de normalidad para llevar a cabo el ANOVA de medidas repetidas.
3. A continuación, damos clic en la opción ANOVA del menú superior. Luego, en el apartado clásico, damos clic en ANOVA de medidas repetidas.
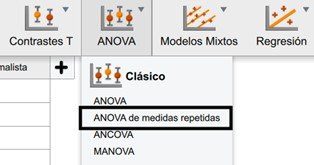
4. Ubicamos nuestras variables en la caja de asignación y cambiamos el nombre de la variable “Factor de MR 1” a Preferencia. En nuestro caso, la variable independiente tiene 3 niveles, por lo cual renombramos los primeros dos niveles a Tradicional y Ecológico. Luego, damos clic sobre el recuadro “Nuevo nivel” y escribimos Minimalista Una vez hecho, las variables aparecerán en la caja Celdas de Medidas Repetidas. Ahora, añadimos los datos apropiados al nivel correspondiente.
Este procedimiento inmediatamente realiza el ANOVA de medidas repetidas.
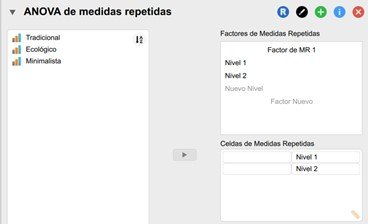
Los cambios deben verse de la siguiente manera.
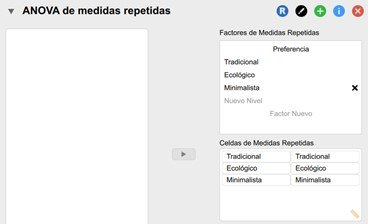
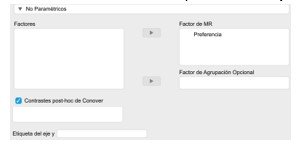
5. A continuación, para obtener los resultados de la prueba de Friedman, nos desplazamos al apartado “No paramétricos” y ubicamos la variable en la caja de asignación y seleccionamos la opción Contrastes Post hoc de Conover. Adicionalmente, nos dirigimos al apartado “Gráficos de tipo Nube con Lluvia” y ubicamos la variable “Actividad Principal” en la sección “Eje Horizontal”.
6. Interpretación de Resultados.
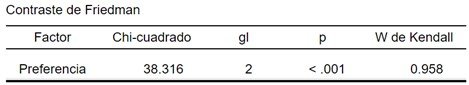
El valor-p obtenido al realizar la prueba Friedman es menor al nivel de significancia establecido (α = 0.05), lo que indica que es significativo. Por esta razón, se rechaza la hipótesis nula y se afirma que existen diferencias estadísticamente importantes entre las medidas de tendencia central de al menos dos grupos.
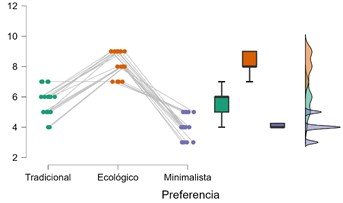
Por su parte, el gráfico de nubes con lluvia nos permite ver la distribución de puntuaciones por grupo. En primera instancia, es posible observar que el empaque Ecológico es el más preferido por los consumidores, seguido del Tradicional y el Minimalista. Adicionalmente, vemos que la distribución para cada grupo no sigue la curva normal, sino que se encuentra sesgada. A esto se suma que la separación de las distribuciones y cajas entre los grupos refleja las diferencias en las preferencias, coincidiendo con los resultados significativos de la prueba de Friedman.
Interpretación de Resultados.
7. En vista de que la prueba de Friedman es significativa, JASP proporciona la opción de ejecutar la prueba post hoc de Conover. Así, para determinar cuáles grupos son diferentes, revisaremos los resultados de la tabla de Comparaciones Post hoc de Conover.
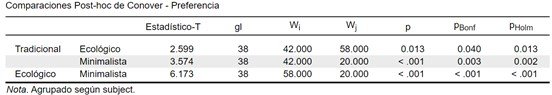
Tras realizar el método de comparaciones múltiples, es posible concluir que existen diferencias significativas (α menor a 0.05) en la preferencia entre todos los pares de empaques. Esto significa que el tipo de empaque tiene un impacto significativo en la preferencia de los consumidores, y que la empresa debe considerar estas diferencias al elegir o rediseñar sus empaques para maximizar su atractivo visual y satisfacer las preferencias de los consumidores.
Referencias.
Demšar, J. (2006). Statistical comparisons of classifiers over multiple data sets. Journal of Machine learning research, 7(Jan), 1-30.
Mendenhall, W., Beaver, R. J., y Beaver, B. M. (2010). Introducción a la probabilidad y estadística. 13ª. Edición. México: Cengage Learning.
Pereira, D. G., Afonso, A., y Medeiros, F. M. (2015). Overview of Friedman’s test and post-hoc analysis. Communications in Statistics – Simulation and Computation, 44(10), 2636-2653. https://doi.org/10.1080/03610918.2014.931971
Pérez-Tejada, H. (2008). Estadística para las ciencias sociales, del comportamiento y de la salud. Cengage Learning. 3ª. Edición. México: Cengage Learning.
Pohlert, T. (2025). Package ‘pmcmrplus’. R Foundation for Statistical Computing, Vienna, Austria.
Siegel, S., y Castellán, J.N. (1995). Estadística no paramétrica aplicada a las ciencias de la conducta.
Add Comment