




¿Qué es la curva característica del ítem – CCI – en IRT?
.
Por: Cristian Stiven Tarapues Calpa
Dos personas pueden obtener la misma puntuación en una prueba y, sin embargo, haber respondido ítems de distinta dificultad. La teoría de respuesta al ítem (TRI) estudia esta relación entre las características de las preguntas y el nivel de las personas en aquello que se pretende medir. Una de sus herramientas centrales es la Curva Característica del Ítem (CCI), que ayuda a comprender cómo funciona cada pregunta, más allá de contar respuestas correctas (Baker, 2001; Attorresi et al., 2009).
En este blog nos centraremos en modelos dicotómicos o con ítems con dos resultados posibles, como correcto e incorrecto, el objetivo es aprender a leer una CCI y reconocer qué cambia al utilizar modelos de uno, dos o tres parámetros.
Además, la diferencia frente a una proporción de aciertos es importante. Si el 70 % de una muestra respondió bien una pregunta, conocemos su resultado general, pero no cómo varía entre personas con niveles distintos de habilidad. La CCI representa esa relación mediante un modelo estadístico y para obtenerla en una investigación hay que analizar respuestas reales y estimar sus parámetros; las curvas de este blog, en cambio, utilizan valores elegidos para mostrar cómo se interpretan (Baker, 2001).
¿Qué muestra una CCI?
Una CCI representa la probabilidad de responder correctamente a un ítem según el nivel de habilidad o rasgo de la persona, que se simboliza con θ (theta), el eje horizontal muestra ese nivel; el vertical expresa una probabilidad entre 0 y 1. Por ejemplo, 0,70 significa una probabilidad del 70 % de obtener una respuesta correcta. La curva no predice con certeza qué hará una persona: describe cómo cambia esa probabilidad (Baker, 2001).
La misma idea puede aplicarse a preguntas de opinión o bienestar. Por ejemplo, ante la afirmación «Me siento satisfecho con mi vida», las respuestas podrían codificarse como 0 = «No estoy de acuerdo» y 1 = «Estoy de acuerdo». En este caso, responder 1 no significa acertar, sino expresar acuerdo con la afirmación. Por eso, para interpretar la curva es importante conocer cómo se codificaron las respuestas (Nguyen et al., 2014).
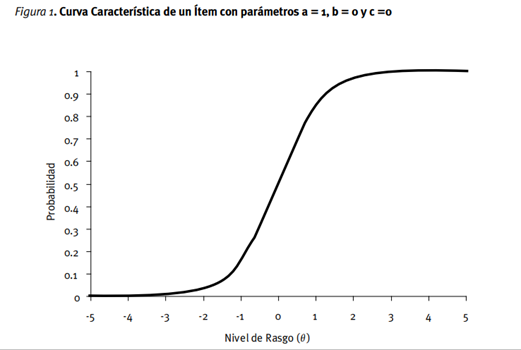
La Figura 1 tiene la conocida forma de S. Cuando el nivel del rasgo aumenta, también lo hace la probabilidad de respuesta correcta. En el centro de la curva, pequeños cambios de habilidad producen variaciones más visibles en esa probabilidad. Así, la forma concreta depende del modelo escogido y no todas las curvas tienen la misma inclinación ni empiezan cerca de cero.
El nivel del rasgo tampoco equivale directamente a una nota escolar o a un porcentaje de respuestas correctas. En los gráficos suele expresarse sobre una escala cuyo centro se fija como referencia. Un valor de cero no significa falta de habilidad, del mismo modo que un valor negativo no indica incapacidad, su interpretación depende de la escala construida y del instrumento utilizado. Por eso conviene leer ambos ejes antes de comparar curvas (Embretson y Reise, 2000).
Modelos de la curva característica del ítem
Para entender por qué las curvas no siempre tienen la misma forma, conviene distinguir los modelos de uno, dos y tres parámetros. Todos relacionan el nivel del rasgo de la persona (θ) con la probabilidad de responder 1, pero no describen de la misma manera las características de los ítems. La dificultad (bᵢ) indica dónde se sitúa un ítem; la discriminación (aᵢ), cuánto cambia la probabilidad cerca de ese punto; y el pseudoacierto (cᵢ), el límite inferior de la probabilidad en el modelo 3PL. La respuesta 1 puede representar un acierto o una categoría determinada por la codificación del instrumento (Baker, 2001; Embretson y Reise, 2000).
Modelo de un parámetro (1PL o Rasch)
El punto de partida es el modelo de un parámetro (1PL), conocido como modelo de Rasch. La probabilidad de responder 1 depende de la diferencia entre el nivel del rasgo de la persona (θ) y la dificultad del ítem (bᵢ). Todos los ítems comparten una misma discriminación, fijada en 1 en la escala utilizada; por eso la ecuación incluye únicamente la dificultad. Cuando θ = bᵢ, la probabilidad de responder 1 es 0,50 (Baker, 2001).
Además, la dificultad indica la posición del ítem: cuanto mayor es bᵢ, más elevado debe ser el nivel del rasgo para alcanzar una misma probabilidad de respuesta.
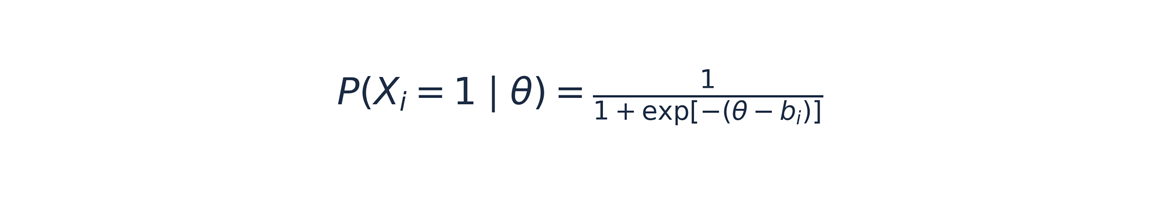
En la ecuación, P(Xᵢ = 1 | θ) representa la probabilidad de responder 1; θ es el nivel del rasgo, bᵢ la dificultad del ítem y exp la función exponencial. La diferencia entre θ y bᵢ determina la probabilidad. Como los ítems comparten la misma discriminación, sus curvas conservan la forma y solo cambian de posición.
Un ejemplo ayuda a interpretar la ecuación. Para un ítem con dificultad b = 1, una persona situada en θ = 0 tiene cerca de un 27 % de probabilidad de responder 1. Si su nivel es θ = 1, la probabilidad aumenta al 50 %; con θ = 2 se aproxima al 73 %. Estas cifras no describen a tres personas reales. Muestran cómo, bajo Rasch, una misma pregunta puede presentar probabilidades diferentes según el nivel del rasgo.
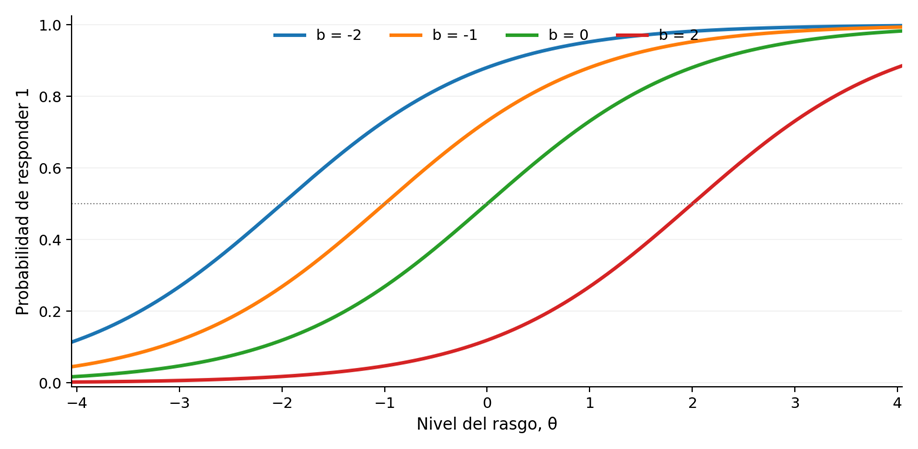
La Figura 2 permite comparar cuatro ítems. La curva situada más a la izquierda corresponde al más fácil (b = −2), mientras que la más alejada a la derecha representa al más difícil (b = 2). Todas pasan por 0,50 en su propio valor de dificultad. Describirlas como curvas desplazadas es más preciso que afirmar que son líneas paralelas.
El desplazamiento de las curvas permite ver por qué una prueba no necesita estar formada solo por preguntas fáciles o solo por preguntas difíciles. Los ítems situados en diferentes puntos de la escala ayudan a explorar distintos niveles de habilidad y su utilidad depende de a quién se evalúa y de para qué se usarán las puntuaciones. Una pregunta difícil no es necesariamente mejor; puede aportar poca información si casi nadie de la población evaluada alcanza niveles próximos a su dificultad (Baker, 2001).
Modelo de dos parámetros (2PL)
El modelo de dos parámetros (2PL) permite que los ítems tengan distinta capacidad para diferenciar personas. Añade el parámetro de discriminación (aᵢ), que indica qué tan rápido cambia la probabilidad de responder 1 cuando varía el nivel del rasgo. Cuanto mayor es aᵢ, más pronunciada es la curva cerca de la dificultad (bᵢ). Como en Rasch, cuando θ = bᵢ la probabilidad es 0,50 (Embretson y Reise, 2000).
De esta manera, dos ítems pueden tener la misma dificultad y, aun así, distinguir con distinta intensidad a personas con niveles similares del rasgo. La diferencia respecto al 1PL está en la pendiente, que ya no tiene que ser igual para todos los ítems.
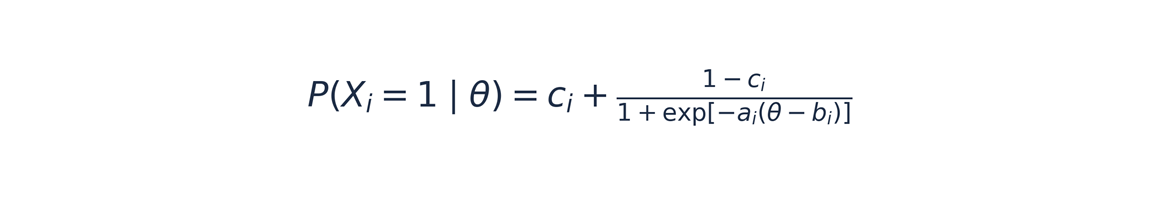
En esta expresión, P(Xᵢ = 1 | θ), θ, bᵢ y exp mantienen el significado anterior. El parámetro aᵢ multiplica la diferencia entre θ y bᵢ y determina la inclinación de la curva: a mayor discriminación, más rápido cambia la probabilidad cerca de la dificultad del ítem.
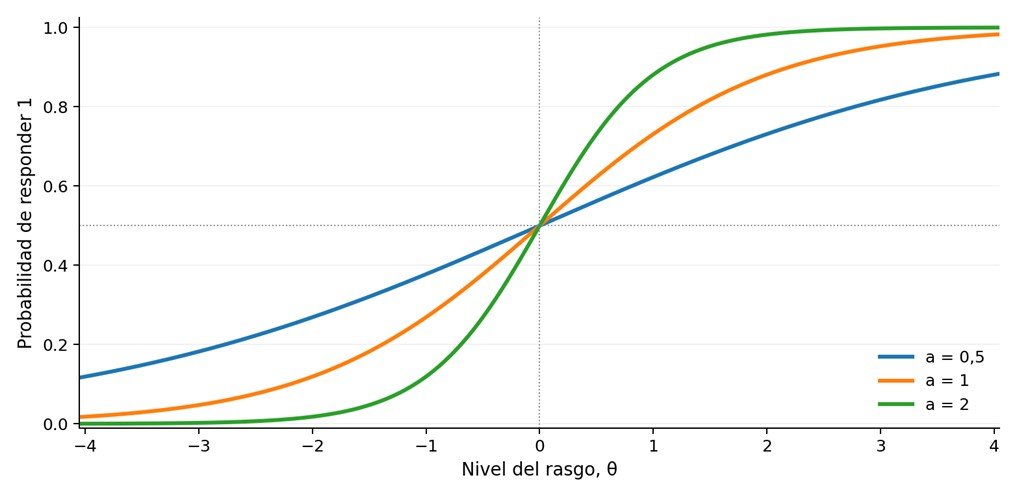
En la Figura 3, las curvas se cruzan en θ = 0 porque comparten la misma dificultad. La más pronunciada distingue con mayor intensidad niveles próximos a ese punto. Esto no significa que un ítem deba tener siempre la mayor discriminación posible: su utilidad depende del propósito de la prueba, del contenido y del ajuste del modelo.
En una prueba real, los ítems pueden variar a la vez en dificultad y discriminación. Por ello, al comparar curvas 2PL no basta con observar cuál está más a la derecha o cuál sube más rápido: ambas características deben leerse por separado. Incluso pueden cruzarse cuando sus pendientes y posiciones son diferentes. La Figura 3 aísla la discriminación precisamente para que se entienda su efecto sin mezclarlo con cambios de dificultad (Baker, 2001).
Modelo de tres parámetros (3PL)
En pruebas de opción múltiple puede haber respuestas correctas incluso entre personas con niveles muy bajos del rasgo. El modelo de tres parámetros (3PL) incorpora el pseudoacierto (cᵢ), además de la dificultad (bᵢ) y la discriminación (aᵢ). Este parámetro representa el límite inferior al que se aproxima la probabilidad de respuesta 1; no permite saber si una respuesta concreta fue adivinada (Baker, 2001; Embretson y Reise, 2000).
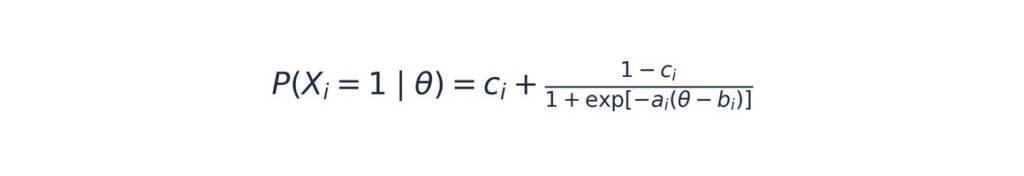
La ecuación conserva el significado de θ, bᵢ, aᵢ y exp. Añade cᵢ, que indica el límite inferior de la probabilidad de responder 1; el término (1 − cᵢ) ajusta el resto de esa probabilidad. Por ello, la curva se aproxima a cᵢ en niveles muy bajos del rasgo.
La dificultad cambia de interpretación frente a los modelos anteriores: cuando θ = bᵢ, la probabilidad es (1 + cᵢ)/2, no necesariamente 0,50. Por ejemplo, si cᵢ = 0,20, en ese punto la probabilidad es 0,60.
Aunque el pseudoacierto suele relacionarse con la adivinación, su valor no tiene por qué coincidir con la fracción de respuestas correctas que se esperaría al elegir una alternativa al azar. Por ejemplo, en un ítem de cuatro opciones, la probabilidad de acertar al elegir una respuesta completamente al azar sería de 0,25 (25 %), porque solo una de las cuatro opciones es correcta. Sin embargo, el parámetro de pseudoacierto (cᵢ) no necesariamente coincide con ese valor, ya que se estima a partir de las respuestas observadas y puede verse influido por el funcionamiento del ítem.
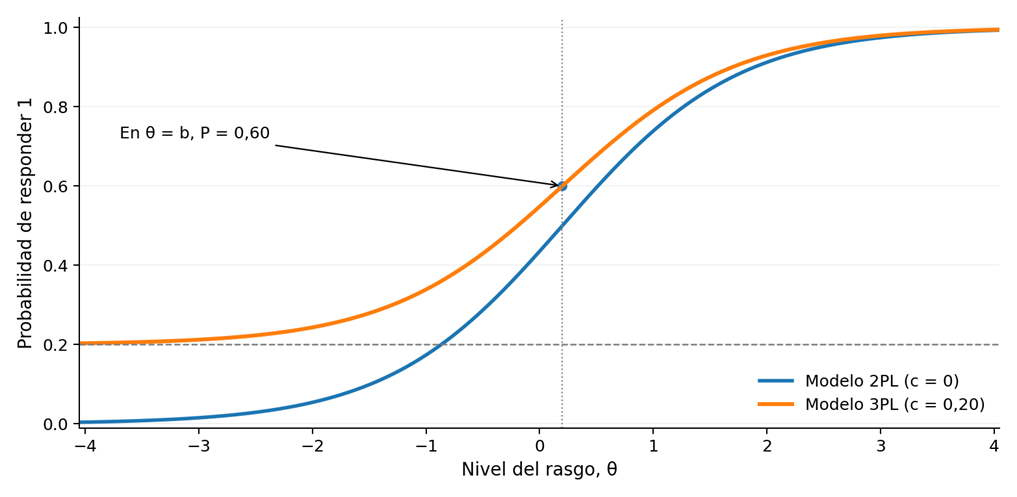
La Figura 4 contrasta dos curvas con la misma dificultad y discriminación. En 2PL la probabilidad se aproxima a cero para niveles muy bajos; en 3PL se aproxima al valor de c. Ambas aumentan con la habilidad, pero no describen la misma relación entre el rasgo y la respuesta.
Las tres ecuaciones describen probabilidades, no respuestas seguras. Rasch mantiene una discriminación común, el 2PL permite que varíe y el 3PL añade una probabilidad mínima de respuesta 1. Finalmente, agregar que un modelo con más parámetros no es automáticamente mejor: su elección debe considerar el tipo de ítems, los datos disponibles y el propósito de la medición (Nguyen et al., 2014).
Supuestos que conviene revisar
Hasta aquí, las figuras muestran relaciones que los modelos predicen. Para interpretarlas en una prueba real necesitamos comprobar si esas predicciones son razonables, los modelos unidimensionales suponen que un rasgo principal explica las respuestas. Si una prueba pretende evaluar cálculo, pero algunas preguntas dependen en gran medida de la comprensión lectora, puede haber más de una habilidad involucrada. La estructura de la prueba debe estudiarse con los datos y el contenido de los ítems (Nguyen et al., 2014).
Para estudiar la unidimensionalidad pueden examinarse las relaciones entre los ítems y contrastarse modelos de uno o varios factores, ningún resultado aislado demuestra que todos midan exactamente lo mismo, también importa leer las preguntas ya que una dimensión estadística predominante puede ocultar contenidos diferentes que conviene revisar. La CCI se interpreta con más fundamento cuando la estructura propuesta tiene sentido tanto en los datos como en la definición del rasgo (Nguyen et al., 2014).
Otro supuesto es la independencia local: entre personas con un mismo nivel del rasgo, las respuestas a los ítems no deberían seguir relacionadas por motivos adicionales, esto puede ocurrir cuando varias preguntas utilizan un mismo texto o se dan pistas entre sí. Se puede explorar el problema mediante las asociaciones entre los residuos, es decir, las diferencias entre las respuestas observadas y las esperadas (Nguyen et al., 2014). Por ejemplo, si ignoramos esa relación adicional, podríamos atribuir al rasgo una parte de la información que proviene del material compartido. Así, la causa debe investigarse examinando también su contenido (Stover et al., 2019).
También se espera monotonicidad: si aumenta el nivel del rasgo, no debería disminuir la probabilidad de responder 1 en los ítems orientados en esa dirección. Por eso importa revisar cómo están redactados y codificados, finalmente, las características de los ítems deberían mantenerse estables entre grupos comparables. Estas condiciones no quedan demostradas porque una curva tenga forma de S (Nguyen et al., 2014).
Otra condición importante es la invarianza de los parámetros: los ítems deberían funcionar de manera comparable entre grupos de personas con el mismo nivel del rasgo. Para examinarla puede utilizarse el análisis de funcionamiento diferencial del ítem (DIF), que permite identificar posibles diferencias entre grupos, aunque estas diferencias no implican necesariamente sesgo y requieren una revisión adicional (Nguyen et al., 2014).
Comprobar si la curva describe las respuestas
La curva se calcula a partir de una ecuación, pero su utilidad depende de qué tan bien represente los datos. Después de estimar un modelo, conviene comparar las probabilidades previstas con las respuestas observadas en distintos niveles del rasgo. Los estadísticos de ajuste y el análisis de residuos ayudan a detectar diferencias que el gráfico teórico no revela. Una curva aparentemente adecuada no sustituye esta comprobación (Baker, 2001; Nguyen et al., 2014).
En la práctica puede agruparse a las personas por niveles próximos del rasgo y observar si la proporción de respuestas 1 se parece a la probabilidad calculada por el modelo. Pero las diferencias sistemáticas merecen atención: tal vez una pregunta se entendió de otra manera o requiere una habilidad que no estaba contemplada. Este examen se completa con medidas de ajuste, porque la similitud visual entre dos trazados puede ser insuficiente para evaluar el comportamiento de un ítem (Nguyen et al., 2014).
Si un ítem no se ajusta al modelo, habría que examinar su redacción, su contenido y el patrón de respuestas antes de eliminarlo. También conviene valorar si la muestra permite estimar los parámetros con suficiente precisión. El modelo 3PL, por ejemplo, incorpora más parámetros que Rasch y necesita información adecuada para estimarlos; no debe elegirse solo porque sea más flexible (Nguyen et al., 2014).
La cantidad de datos necesaria no es idéntica para todos los modelos ni para todos los ítems. Si casi nadie responde correctamente a una pregunta muy difícil, la estimación de su curva puede tener bastante incertidumbre. Esto no significa que debamos eliminarla de inmediato: primero hay que valorar qué población se evaluó y si la pregunta corresponde al objetivo del instrumento. Una revisión psicométrica adecuada combina la información estadística con el juicio sobre su contenido (Stover et al., 2019).
¿Para qué sirve la CCI al revisar una prueba?
Las CCI permiten identificar qué ítems funcionan en los niveles del rasgo que interesa evaluar. Si una prueba busca distinguir a personas con niveles bajos, conviene contar con preguntas cuya dificultad se sitúe cerca de esa zona. Esta información ayuda a revisar y seleccionar ítems, siempre junto con su pertinencia teórica y su contenido (Baker, 2001).
Pensemos en una prueba que se utilizará para identificar a estudiantes que necesitan apoyo inicial. Incluir únicamente preguntas muy difíciles ofrecería poca capacidad para distinguir entre quienes tienen habilidades bajas, sería preferible disponer de ítems situados cerca de los niveles donde se tomarán decisiones, sin perder de vista los contenidos que el instrumento debe representar. Las CCI permiten examinar esa correspondencia entre la dificultad de las preguntas y las características de la población (Baker, 2001).
De una CCI también puede calcularse la información del ítem, que indica dónde se mide con mayor precisión. Cuanta más información proporciona un ítem, menor es el error de medición esperado y mayor la precisión con la que se estima el nivel del rasgo (Nguyen et al., 2014). La precisión no suele ser igual para todas las personas: depende de la combinación de dificultades y discriminaciones que tenga la prueba. Por eso una puntuación no debe interpretarse sin considerar su incertidumbre (Nguyen et al., 2014).
En los modelos logísticos sin pseudoacierto, un ítem suele aportar más información cerca de su dificultad, donde la curva cambia con mayor rapidez. Lejos de esa zona, su contribución tiende a disminuir. La información de toda la prueba resulta de combinar la que ofrecen sus ítems; por eso la precisión puede ser alta en ciertos niveles y menor en otros. Examinar solo un índice global de confiabilidad puede ocultar estas diferencias importantes (Nguyen et al., 2014).
No debe confundirse la CCI con la curva característica del test. La primera describe un ítem; la segunda muestra el puntaje esperado del conjunto para cada nivel del rasgo. Mirar ambas permite comprender cómo contribuyen las preguntas al resultado general, pero ninguna demuestra por sí sola que el instrumento sea válido o adecuado para cualquier población (Baker, 2001).
La curva característica del test (CCT) puede entenderse como la suma de las probabilidades de respuesta correcta de los ítems. Por ejemplo, si una prueba tiene diez preguntas y, para cierto nivel de habilidad, esas probabilidades suman seis, la puntuación esperada es de seis respuestas correctas. Esto no significa que todas las personas con ese nivel vayan a acertar exactamente seis, pues sus resultados individuales pueden variar (Baker, 2001). Para profundizar en este concepto y comprender cómo se interpreta la curva a nivel de toda la prueba, puedes consultar el blog publicado en SIEPSI sobre CCT (Tarapues Calpa, 2026).
Un límite importante: no todos los ítems se responden con 0 o 1
Una escala de frecuencia o de acuerdo puede ofrecer varias categorías ordenadas, como «nunca», «a veces» y «siempre». Para analizar este tipo de respuestas se utilizan modelos politómicos, que permiten estudiar cómo cambia la probabilidad de elegir cada categoría según el nivel del rasgo. A diferencia de los modelos dicotómicos abordados en este blog, su interpretación no se limita a dos posibles respuestas. Para profundizar en estas diferencias, te invitamos a leer el blog «Modelos politómicos en la Teoría de Respuesta al Ítem (TRI) y su clasificación» de SIEPSI.
Otro ejemplo es la evaluación de actitudes hacia las matemáticas mediante categorías de acuerdo. Rodríguez Jiménez y Mora Mojica (2016) utilizaron el modelo de respuesta graduada de Samejima para analizar este tipo de respuestas. Si deseas conocer esta aplicación, puedes consultar el material de Mora (2016) alojado en SIEPSI.
Para cerrar
Leer una CCI permite reconocer parámetros útiles para construir y revisar pruebas, pero debe acompañarse de evidencia sobre los supuestos, el ajuste, la precisión y el contenido de los ítems. Aunque los ejemplos presentados permiten comprender el funcionamiento de las curvas, en una evaluación real es necesario estimarlas a partir de las respuestas obtenidas y comprobar qué tan bien representan el comportamiento de los ítems.
Herramientas y software:
- Paquete de R ltm para modelamiento TRI y cálculo de CCI
- jMetrik para análisis de CCI y CCT con interfaz gráfica
- Guía de uso de IRTPRO para estimación de parámetros y visualización
Bibliografía
Attorresi, H. F., Lozzia, G. S., Abal, F. J. P., Galibert, M. S., y Aguerri, M. E. (2009). Teoría de respuesta al ítem: conceptos básicos y aplicaciones para la medición de constructos psicológicos. Revista Argentina de Clínica Psicológica, 18(2), 179–188. https://dialnet.unirioja.es/servlet/articulo?codigo=4266943
Baker, F. B. (2001). The basics of item response theory (2.ª ed.). ERIC Clearinghouse on Assessment and Evaluation. https://eric.ed.gov/?id=ED458219
Embretson, S. E., y Reise, S. P. (2000). Item response theory for psychologists. Lawrence Erlbaum Associates. https://www.routledge.com/Item-Response-Theory/Embretson-Reise-Embretson-Reise/p/book/9781410605269
Mora, S. (2016). Análisis psicométrico del instrumento actitudes hacia las matemáticas mediante el modelo de respuesta graduada de Samejima [resumen de investigación alojado en SIEPSI]. https://siepsi.com.co/wp-content/uploads/2022/07/Mora-S.-2016.pdf
Nguyen, T. H., Han, H.-R., Kim, M. T., y Chan, K. S. (2014). An introduction to item response theory for patient-reported outcome measurement. Patient, 7(1), 23–35. https://doi.org/10.1007/s40271-013-0041-0
Rodríguez Jiménez, O., y Mora Mojica, S. E. (2016). Análisis psicométrico del instrumento actitudes hacia las matemáticas mediante el modelo de respuesta graduada de Samejima. Actualidades en Psicología, 30(120), 7–30. https://doi.org/10.15517/ap.v30i120.18722
Stover, A. M., McLeod, L. D., Langer, M. M., Chen, W.-H., y Reeve, B. B. (2019). State of the psychometric methods: Patient-reported outcome measure development and refinement using item response theory. Journal of Patient-Reported Outcomes, 3, 50. https://doi.org/10.1186/s41687-019-0130-5
Tarapues Calpa, C. S. (2026, 20 de febrero). ¿Qué es la curva característica del test – CCT – en IRT? SIEPSI. https://siepsi.com.co/2026/02/20/que-es-la-curva-caracteristica-del-test-cct-en-irt/
Valdés Veloz, H. (2014). Introducción a la teoría de respuestas al ítem. Instituto Dominicano de Evaluación e Investigación de la Calidad Educativa (IDEICE). https://ideice.gob.do/documentacion/publicaciones-id-22-introduccion-a-la-teoria-de-respuestas-al-item-tri
Add Comment