



La desviación mediana absoluta: cómo medir la dispersión cuando los datos no ayudan

.
Por: Diego Fernando Pulido Parra
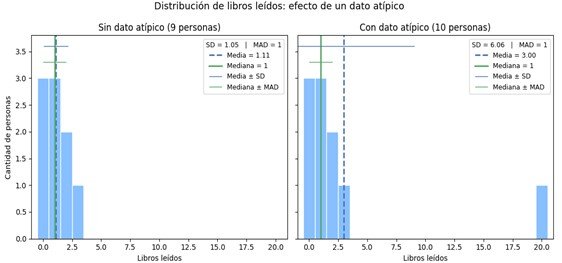
Imagina que estás realizando una encuesta sobre cuántos libros leyeron las personas el año pasado y obtienes los siguientes datos: 0, 0, 0, 1, 1, 1, 2, 2, 3, 20. La persona que leyó más libros leyó 20, casi siete veces más que la segunda persona, la cual leyó 3. Con las primeras nueve personas, la media será de 1.1, pero al llegar la décima persona la media pasará a ser 3, lo cual ya no representa muy fielmente los datos porque esta medida de tendencia central es arrastrada hacia una de las colas de la distribución, perdiendo así su funcionalidad como, precisamente, medida de tendencia central. La mediana, en cambio, permanecerá en 1 con o sin la décima persona dado que no depende de la magnitud o el tamaño de los datos sino de su posición en la distribución.
Esto mismo ocurre cuando, además del centro de los datos, queremos medir qué tan dispersos están. La desviación estándar es tan sensible a los valores extremos como el promedio, y ante la presencia de un valor atípico, puede dar una impresión errónea de la dispersión de los datos.
Es aquí que surge la pregunta de si existe una forma de medir la dispersión de un conjunto de datos sin que los valores atípicos afecten qué tan fielmente se representan los datos. Dicha medida existe y es la desviación mediana absoluta, conocida por sus siglas en inglés como MAD.
La MAD se define como la mediana de las distancias absolutas entre cada dato y la mediana de la distribución (Arachchige & Prendergast, 2024; Pham-Gia & Hung, 2001). Aunque sus raíces conceptuales se remontan a Gauss, la MAD fue redescubierta y formalizada en el siglo XX como herramienta esencial para trabajar con datos sesgados o con anomalías (Arachchige & Prendergast, 2024). Para calcularla, primero encontramos el centro de los datos usando la mediana, luego medimos qué tan lejos está cada dato de ese centro, y finalmente calculamos la mediana de esas distancias.
Este doble uso de la mediana es justamente lo que le da su fortaleza. La literatura estadística señala que el punto de ruptura de una medida de dispersión es la proporción de contaminación que puede tolerar antes de dar resultados poco fiables. La desviación estándar tiene un punto de ruptura de 0, mientras que la MAD tiene un punto de ruptura de 1/2, el máximo posible para cualquier estimador (Hampel, 1978). Esto significa que hasta la mitad de los datos de una muestra podrían ser atípicos, y la MAD seguiría entregando un resultado confiable, mientras que la desviación estándar comenzaría a variar al cambiar cualquiera de sus datos.
A diferencia de las medidas basadas en promedios, la MAD posee lo que se conoce como una función de influencia acotada, lo que limita estrictamente cuánto puede afectar al resultado un solo dato, sin importar qué tan extremo sea. Esto la hace adecuada para representar datos sesgados o distribuciones con datos atípicos (Arachchige & Prendergast, 2024).
Retomando el ejemplo del principio, con las primeras nueve personas se tendría una desviación estándar de 1.05, la cual llegaría a 6.06 con la décima persona. La MAD, en cambio, permanecerá en 1. Esto se puede ver con mayor claridad en la siguiente gráfica:
Esta robustez hace que la MAD resulte especialmente útil en varios escenarios de investigación. El primero, ya mencionado, es la presencia de valores atípicos o contaminación en los datos, donde suele ser un mejor estimador de escala que la desviación estándar en muestras grandes (Pham-Gia & Hung, 2001). El segundo son las distribuciones sesgadas, en las que la desviación estándar y las pruebas asociadas a ella tienden a ser poco fiables o engañosas (Arachchige & Prendergast, 2024). El tercero son las muestras con distribuciones de cola pesada, es decir, aquellas que tienen más datos a un lado de su centro que del otro. Aunque bajo una normalidad estricta la MAD es menos eficiente que la desviación estándar (63.7%), su eficiencia la supera notablemente en otros contextos, como con la distribución de Laplace, donde llega a ser el doble de eficiente, y la distribución de Cauchy, donde su eficiencia con respecto a la desviación estándar tiende a infinito (Pham-Gia & Hung, 2001).
También destaca por su facilidad de interpretación, pues al basarse en operaciones de primer grado ofrece una medida más natural de la dispersión que la desviación estándar, cuyo proceso de elevar al cuadrado y luego extraer la raíz puede resultar artificial en la práctica (Pham-Gia & Hung, 2001).
Históricamente ha sido, además, el estimador no paramétrico natural del “error probable” en física experimental, donde con muestras pequeñas se opta con frecuencia por descartar observaciones dudosas (Arachchige & Prendergast, 2024; Pham-Gia & Hung, 2001).
Más allá de describir datos, la MAD también permite construir inferencias estadísticas robustas. Al desarrollar intervalos de confianza basados en ella, es posible sacar conclusiones fiables sobre la dispersión de una población incluso cuando no podemos asumir que sigue una distribución normal (Arachchige & Prendergast, 2024). Un ejemplo concreto de esto se dio en el análisis de datos de expresión génica en cáncer de próstata, donde los intervalos basados en la MAD lograron identificar diferencias en la dispersión que las pruebas de varianza tradicionales pasaron por alto, precisamente por la influencia de valores atípicos (Arachchige & Prendergast, 2024).
En contextos de investigación y educación, donde los datos rara vez son tan ordenados como la literatura sugiere, contar con una medida de dispersión que resista la presencia de errores de medición, casos extremos legítimos o poblaciones sesgadas resulta tan valioso como contar con un buen promedio.
La MAD nos recuerda que, así como la persona que leyó 20 libros en el ejemplo no debería definir la percepción del resto del grupo, un solo dato extremo tampoco debería definir cuán dispersa creemos que es nuestra información.
Referencias
Arachchige, C. N. P. G., & Prendergast, L. A. (2024). Confidence intervals for median absolute deviations. Communications in Statistics – Simulation and Computation, 1–10. https://doi.org/10.1080/03610918.2024.2376198
Hampel, F. R. 1974. The influence curve and its role in robust estimation. Journal of the American Statistical Association. 69 (346):383–93. doi: 10.2307/2285666.
Pham-Gia, T., & Hung, T. L. (2001). The mean and median absolute deviations. Mathematical and Computer Modelling, 34(7–8), 921–936. https://doi.org/10.1016/s0895-7177(01)00109-1
Add Comment